Aktualizováno Říjen 31, 2026 · Soniqo 's Blog
Měření hlasových agentů: střídání replik, volání nástrojů a expresivní řeč
TurnBench, SLURP a InstructTTSEval výsledky pro lokální runtimes a cloud API, s novými p99 i VAP modely ke stažení.
Čtěte.
Tisk a montáž probíhají
Stavíme malého robota, se kterým si můžete povídat. Čtyři nohy, malý digitální obličej a lokální AI na blízkém notebooku nebo telefonu propojí vaše slova s jeho dalším pohybem.
Seznamte se s Mimi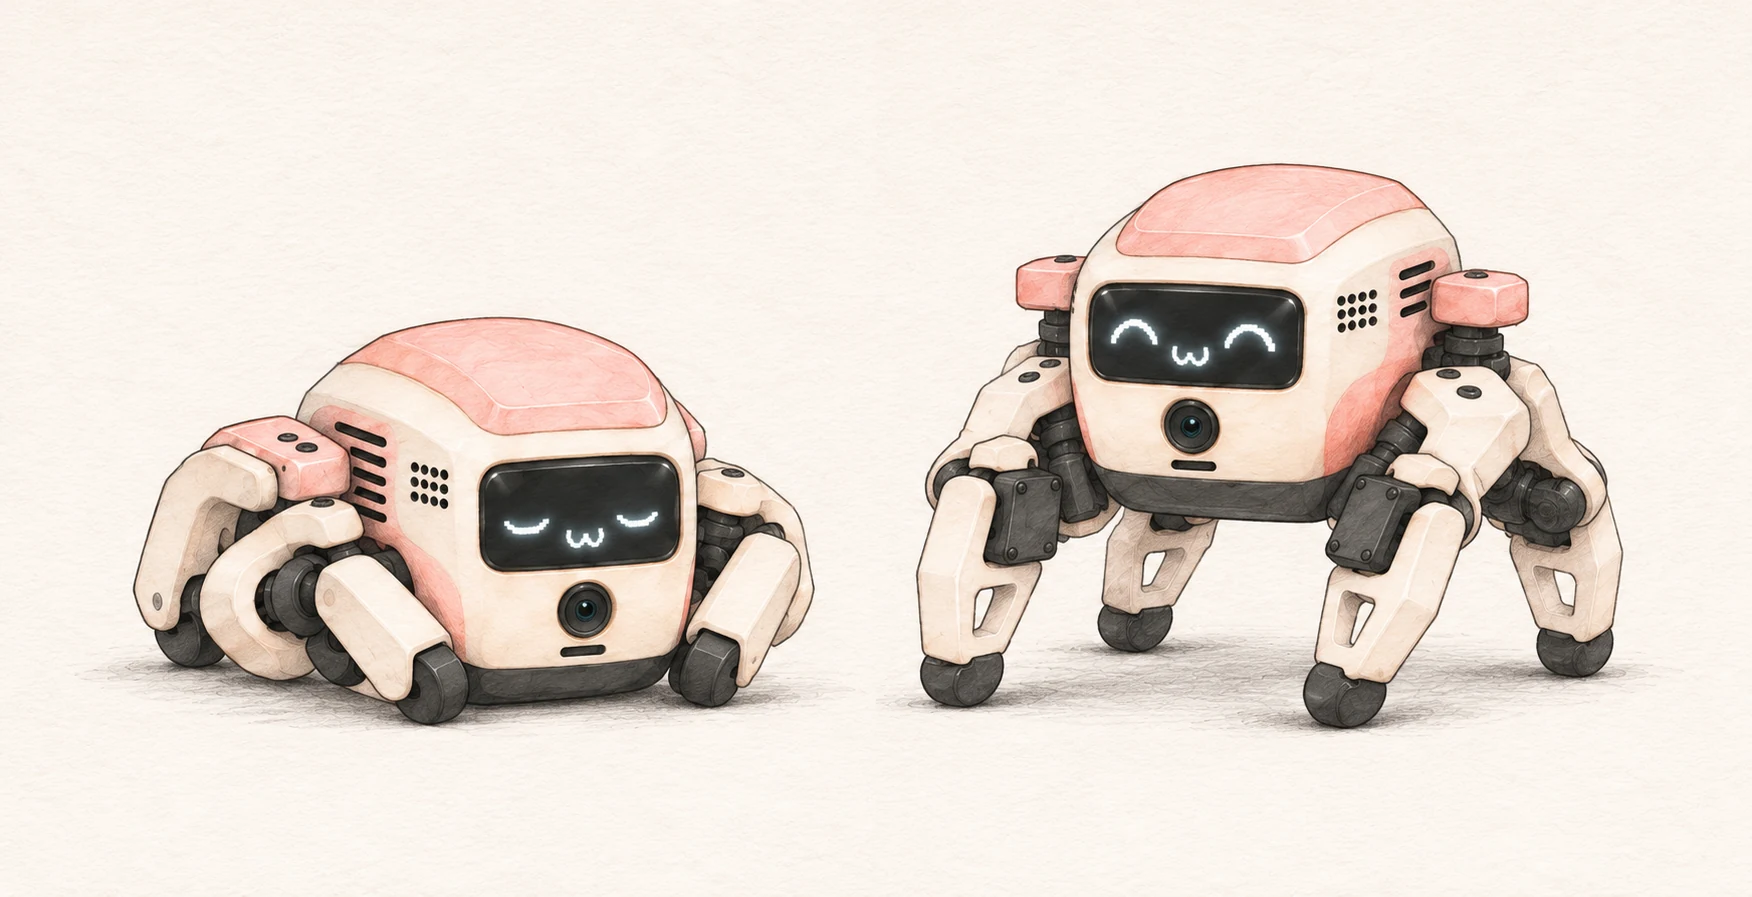
TurnBench, SLURP a InstructTTSEval výsledky pro lokální runtimes a cloud API, s novými p99 i VAP modely ke stažení.
Open- weight GLiNER2.5-Decide v MLX Swift proti TypeSafe 's hosted Jev: co každý nabízí, co publikované měřítko srovnává, a místní měření: 7.6 ms na vyžádání na 0.85 GB se INT8.

Koncepční film zkoumající vizi Stenograf pro přeměnu konverzace v užitečné další kroky.
Od Moshi a PersonaPlex do VoiceChat: jak full- duplex řeči zvládá přerušení a MCP nástroje, a kde menší Android Příkazové potrubí sedí.
Nástroje pro vaše nahrávky a hudbu.
Bezplatná aplikace
Vytvářejte karaoke doprovody z vlastních zvukových souborů. Odstraňte zpěv, oddělte nástroje, změňte tóninu a zdarma exportujte WAV na Android, iPhone a iPad.
Prohlédnout aplikaciHomebrew CLI
Přepis, syntéza řeči a zvukové nástroje, které běží lokálně na počítačích Mac s Apple Silicon.
brew install speechPrůvodce instalacíBezplatné nahrávání a přepis
Soukromé nahrávky a přepisy na Mac, Windows a Android. Volitelná AI na počítači přidává shrnutí a chat.
Prohlédnout aplikaciSlužby
Trénujeme a přizpůsobujeme modely, vyhodnocujeme je na vašich datech a integrujeme je do vašich zařízení nebo soukromé infrastruktury.
Prohlédnout službyVytvářejte rozpoznávání řeči, expresivní hlasy a hlasové ovládání podle toho, jak vaši uživatelé mluví.
Vytvořte si audio potrubí kolem odposlouchávacího prostředí a cílový hardware.
Spusťte modely na zařízení nebo v rámci své vlastní infrastruktury.
Pomozte svým uživatelům najít relevantní zdroje a vybudovat výzkumné pracovní toky, které mohou kontrolovat.
Prozkoumejte architekturu, CLI, API sad SDK a výkonnostní testy jednotlivých komponent.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Experimentální hlasový design · veřejné svazky · postavit SDK hlavní
Experimentální hlasový design · veřejné svazky · postavit SDK hlavní
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Vypustit skóre konce-of-turn, 5.3M, Float32
prognózy Two- kanálků, 5.8M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8