Pomiar agentów głosowych: tury wypowiedzi, wywołania narzędzi i ekspresyjna mowa
Wyniki TurnBench, SLURP i InstructTTSEval dla lokalnych runtimes i cloud API, z nowymi pobraniami modeli p99 oraz VAP.
Drukowanie i montaż w toku
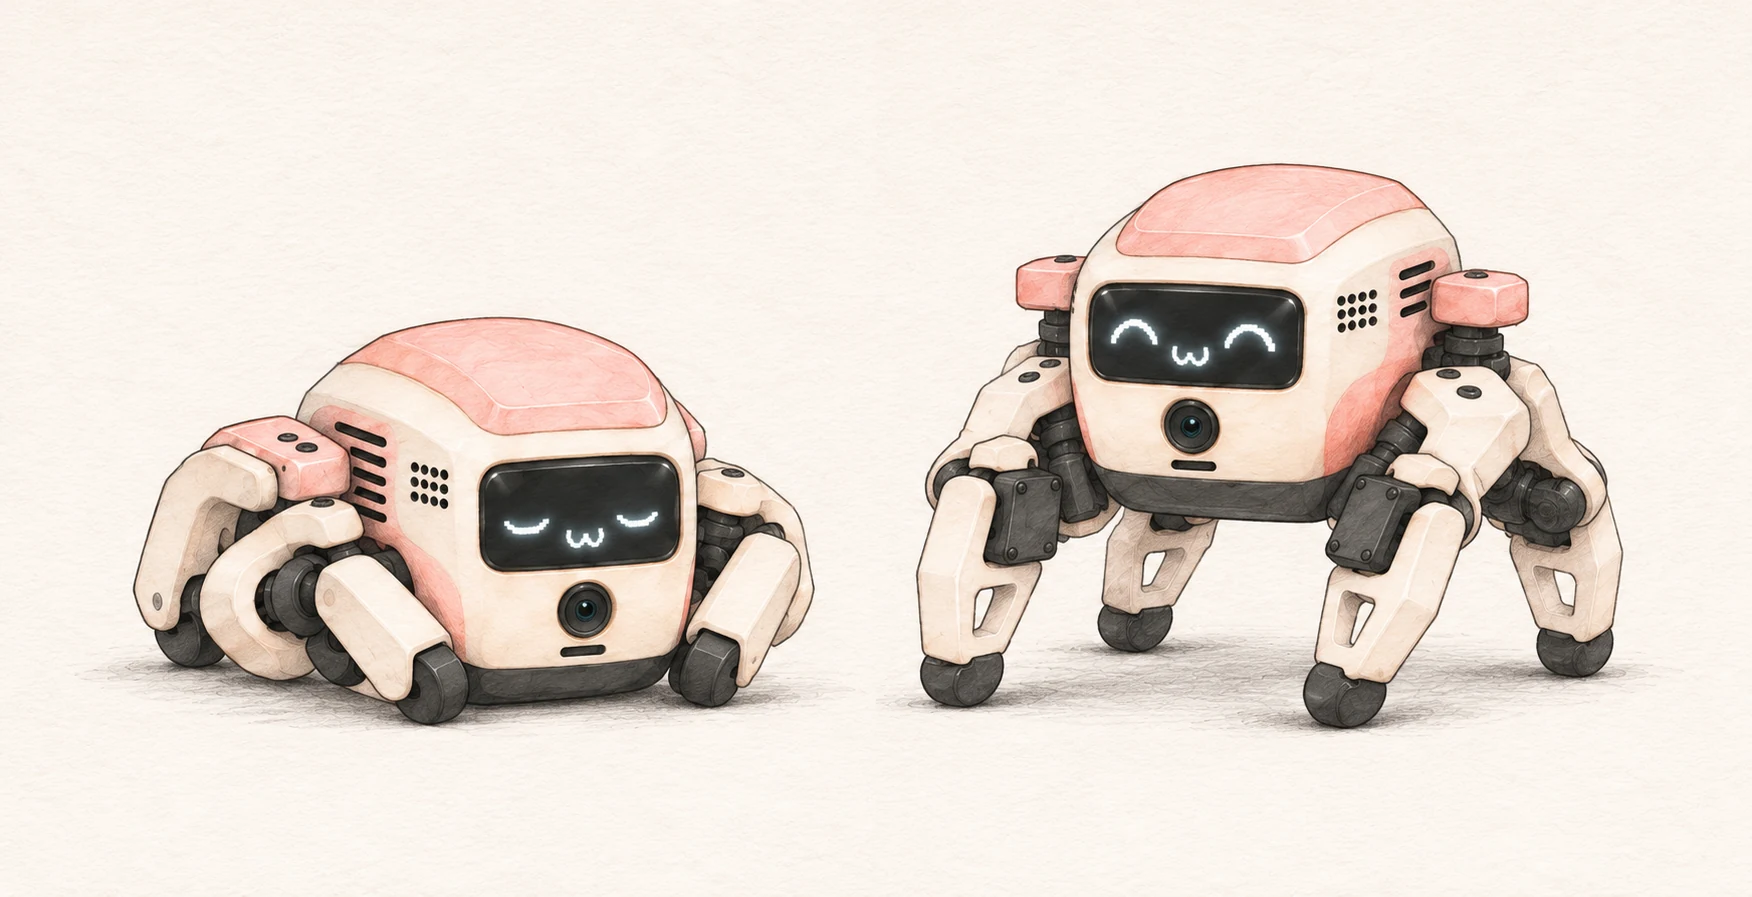
Budujemy małego robota, z którym będzie można rozmawiać. Cztery nogi, niewielka cyfrowa twarz i lokalna AI na pobliskim laptopie lub telefonie połączą Twoje słowa z jego kolejnym ruchem.
Poznaj Mimi
Wyniki TurnBench, SLURP i InstructTTSEval dla lokalnych runtimes i cloud API, z nowymi pobraniami modeli p99 oraz VAP.
Open- weight GLiNER2.5-Decide w MLX Swift przeciwko gościowi TypeSafe Jev: co każdy oferuje, co porównano z opublikowanym wskaźnikiem referencyjnym i lokalne pomiary: 7.6 ms na życzenie na 0.85 GB z INT8.

Koncepcyjny film badający wizję Stenograf w celu przekształcenia rozmów w przydatne kolejne kroki.
Od Moshi i PersonaPlex do VoiceChat: jak fullduplex obsługuje przerywania mowy i narzędzia MCP, i gdzie mniejszy rurociąg poleceń Android pasuje.
Narzędzia do Twoich nagrań i muzyki.
Darmowa aplikacja
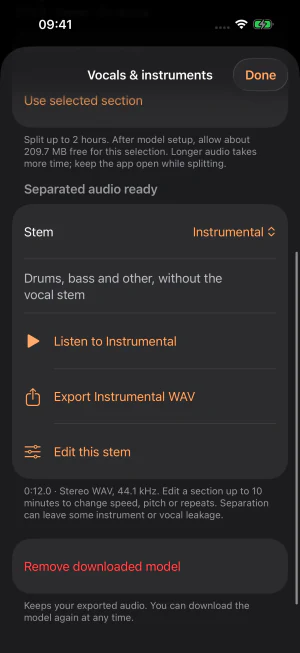
Twórz podkłady karaoke z własnych plików audio. Usuwaj wokal, rozdzielaj ścieżki, zmieniaj tonację i eksportuj WAV za darmo na Androidzie, iPhonie i iPadzie.
Poznaj aplikacjęCLI Homebrew
Transkrypcja, synteza mowy i narzędzia audio działające lokalnie na komputerach Mac z Apple Silicon.
brew install speechInstrukcja instalacjiDarmowa rejestracja i transkrypcja
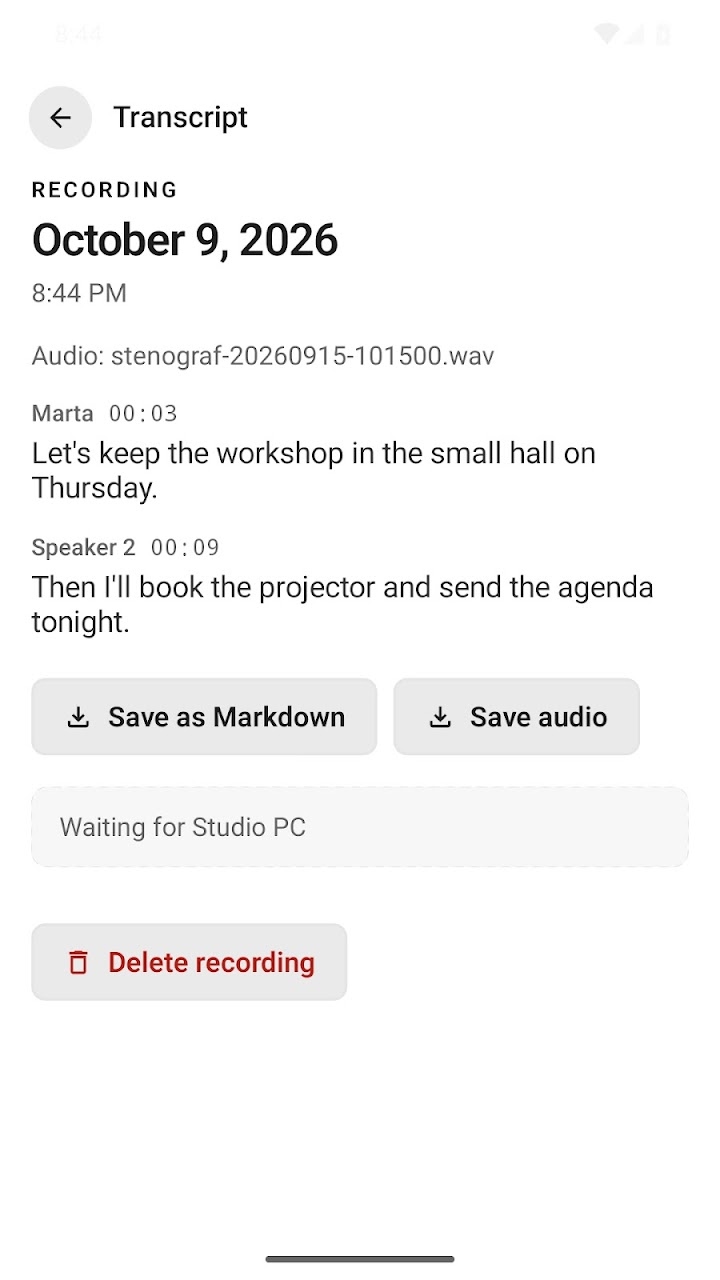
Prywatne nagrania i transkrypcje na Mac, Windows i Android. Opcjonalna AI na komputerze dodaje podsumowania i czat.
Poznaj aplikacjęUsługi
Trenujemy i dostosowujemy modele, oceniamy je na Twoich danych i integrujemy z Twoimi urządzeniami lub prywatną infrastrukturą.
Poznaj usługiTwórz rozpoznawanie mowy, ekspresyjne głosy i sterowanie głosem dostosowane do sposobu, w jaki mówią Twoi użytkownicy.
Zbuduj swój gazociąg audio wokół środowiska słuchania i sprzętu docelowego.
Uruchom swoje modele na urządzeniu lub w obrębie własnej infrastruktury.
Pomoc użytkownikom znaleźć odpowiednie źródła i budować strumienie pracy badawcze mogą sprawdzić.
Poznaj architekturę, CLI, API SDK i wyniki testów każdego komponentu.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Eksperymentalne projektowanie głosu · publiczne pakiety · budowa SDK głównego
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Streaming end- of- turn puncts, 5.3M, Float32
Prognozy przemowy dwukanałowej, 5.8M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8