Pagsukat sa mga voice agent: salitan sa pagsasalita, pagtawag sa mga tool at ekspresibong pananalita
TurnBench, SLURP at InstructTTSEval resulta para sa mga lokal na runtime at cloud APIs, na may bagong p99 and VAP model downloads.
Kasalukuyang pini-print at binubuo
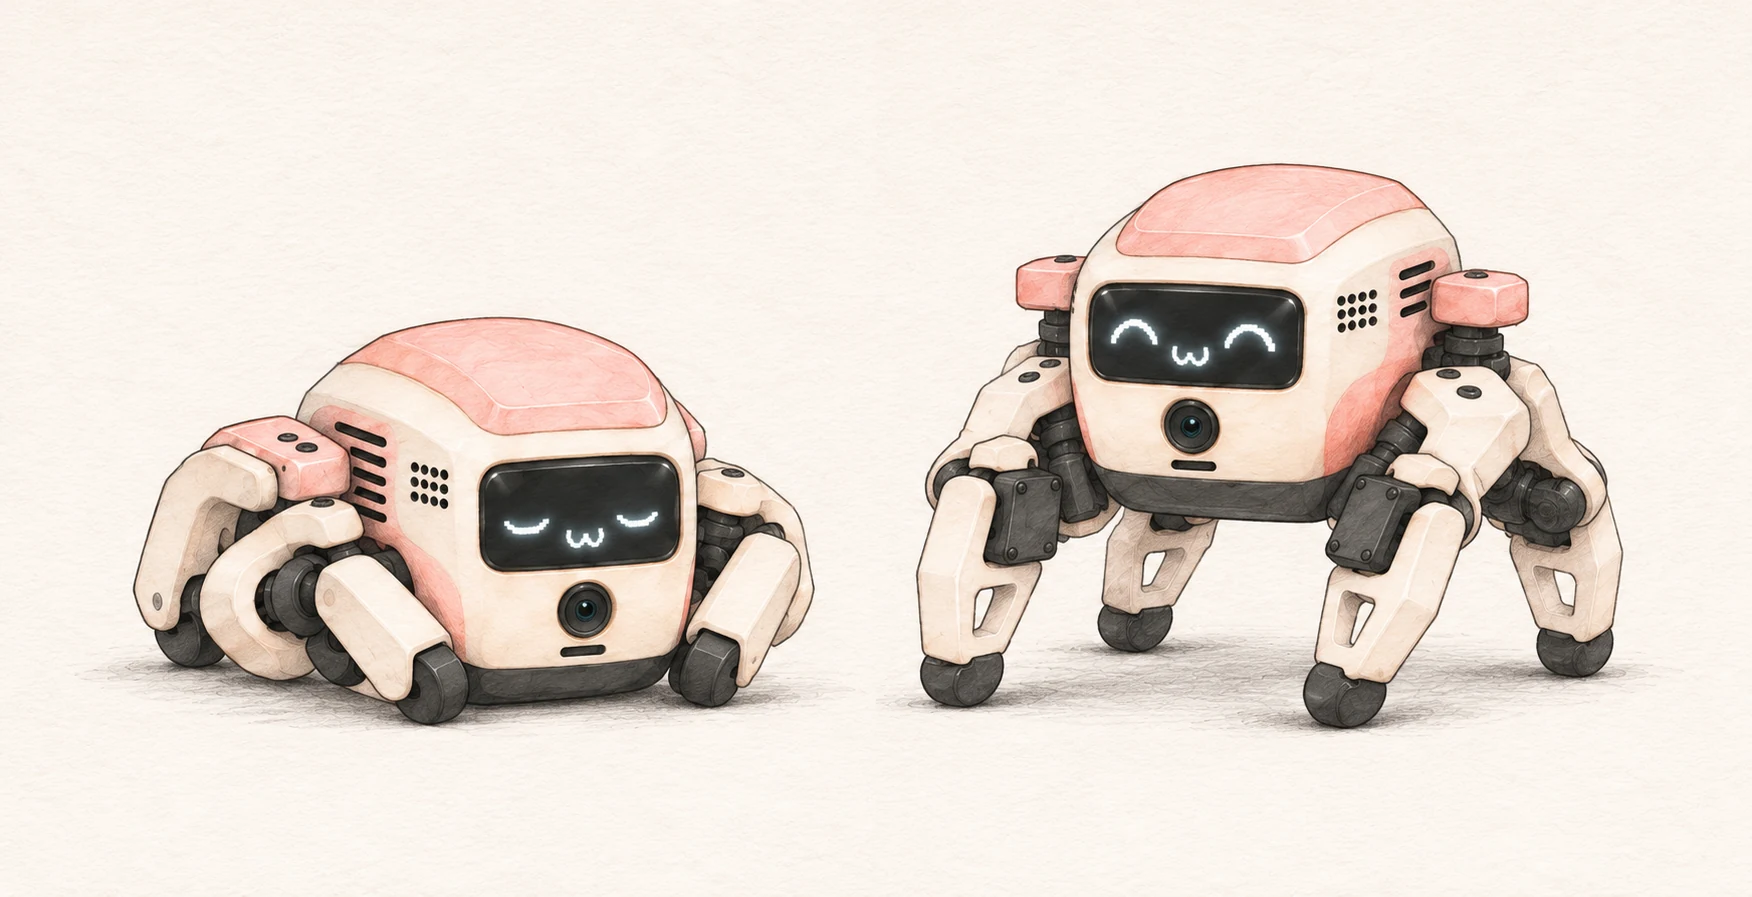
Gumagawa kami ng maliit na robot na maaari ninyong kausapin. Apat na paa, maliit na digital na mukha, at lokal na AI sa kalapit na laptop o telepono ang mag-uugnay sa inyong mga salita sa susunod nitong galaw.
Kilalanin si Mimi
TurnBench, SLURP at InstructTTSEval resulta para sa mga lokal na runtime at cloud APIs, na may bagong p99 and VAP model downloads.
Open-weight GLiNER2.5-Decide sa MLX Swift laban sa TypeHextex EXTORks ang Jev: kung ano ang iniaalok ng bawat isa, kung ano ang inihalintulad ng nalathalang benkmark, at ang lokal na sukat: 7.6 ms kada kahilingan sa 0.85 GB na may INT8.

Isang pelikulang pang-isipan na naggagalugad sa Stenografifts paningin para sa pagbabago ng mga usapan upang maging kapaki-pakinabang na mga susunod na hakbang.
Mula Moshi at PersonaPlex hanggang VoiceChat: kung paano umaangkop ang mga full-duplex speech handrests at mga MCP na kasangkapan, at kung saan nakaangkop ang mas maliit na Android command pipeline.
Mga tool para sa inyong mga recording at musika.
Libreng app
Gumawa ng karaoke backing track mula sa sarili ninyong audio. Alisin ang boses, paghiwa-hiwalayin ang mga instrumento, baguhin ang tono at mag-export ng WAV nang libre sa Android, iPhone at iPad.
Tuklasin ang appHomebrew CLI
Transkripsiyon, speech synthesis at mga audio tool na tumatakbo mismo sa Mac na may Apple Silicon.
brew install speechGabay sa pag-installWalang - bayad na rekording at Pagkopya
Pribadong pagrekord at transkripsiyon sa Mac, Windows at Android. May opsiyonal na desktop AI para sa mga buod at chat.
Tuklasin ang appMga serbisyo
Nagsasanay at nag-aangkop kami ng mga modelo, sinusuri ang mga ito gamit ang inyong datos, at isinasama sa inyong mga device o pribadong imprastraktura.
Tuklasin ang mga serbisyoBumuo ng speech recognition, ekspresibong boses at voice control na naaayon sa paraan ng pagsasalita ng inyong mga gumagamit.
Gumawa ng mga audio pipeline sa palibot ng kapaligiran ng pakikinig at asintahin ang mga hardware.
Itakbo ang iyong mga modelo sa aparato o sa loob ng iyong sariling imprastraktura.
Tulungan ang iyong mga gumagamit na humanap ng kapaki - pakinabang na mga pinagmumulan at gumawa ng mga daloy ng pananaliksik na maaari nilang suriin.
Tuklasin ang arkitektura, CLI, mga SDK API at benchmark ng bawat bahagi.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Mag - eksperimentong disenyo ng boses · bungkos ng mga tao · magtayo ng SDK main
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Streaming end-of-turn scores, 5.3M, Float32
Dalawang-channel na mga propesiya, 5.8M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8