מעודכנת 31 באוקטובר 2026: Soniqo
מדידת סוכנים קוליים: חילופי תורות בדיבור, קריאות לכלים ודיבור הבעתי
TurnBench, SLURP ו InstructTTSEval תוצאות עבור זמני ריצה מקומיים ו- API בענן, עם p99 VAP מודל הורדות.
Read Read Read
הדפסה והרכבה בעיצומן
אנחנו בונים רובוט קטן שאפשר לדבר איתו. ארבע רגליים, פנים דיגיטליות קטנות ו-AI מקומי במחשב נייד או בטלפון סמוך, שיחבר את המילים שלכם לתנועה הבאה שלו.
הכירו את Mimi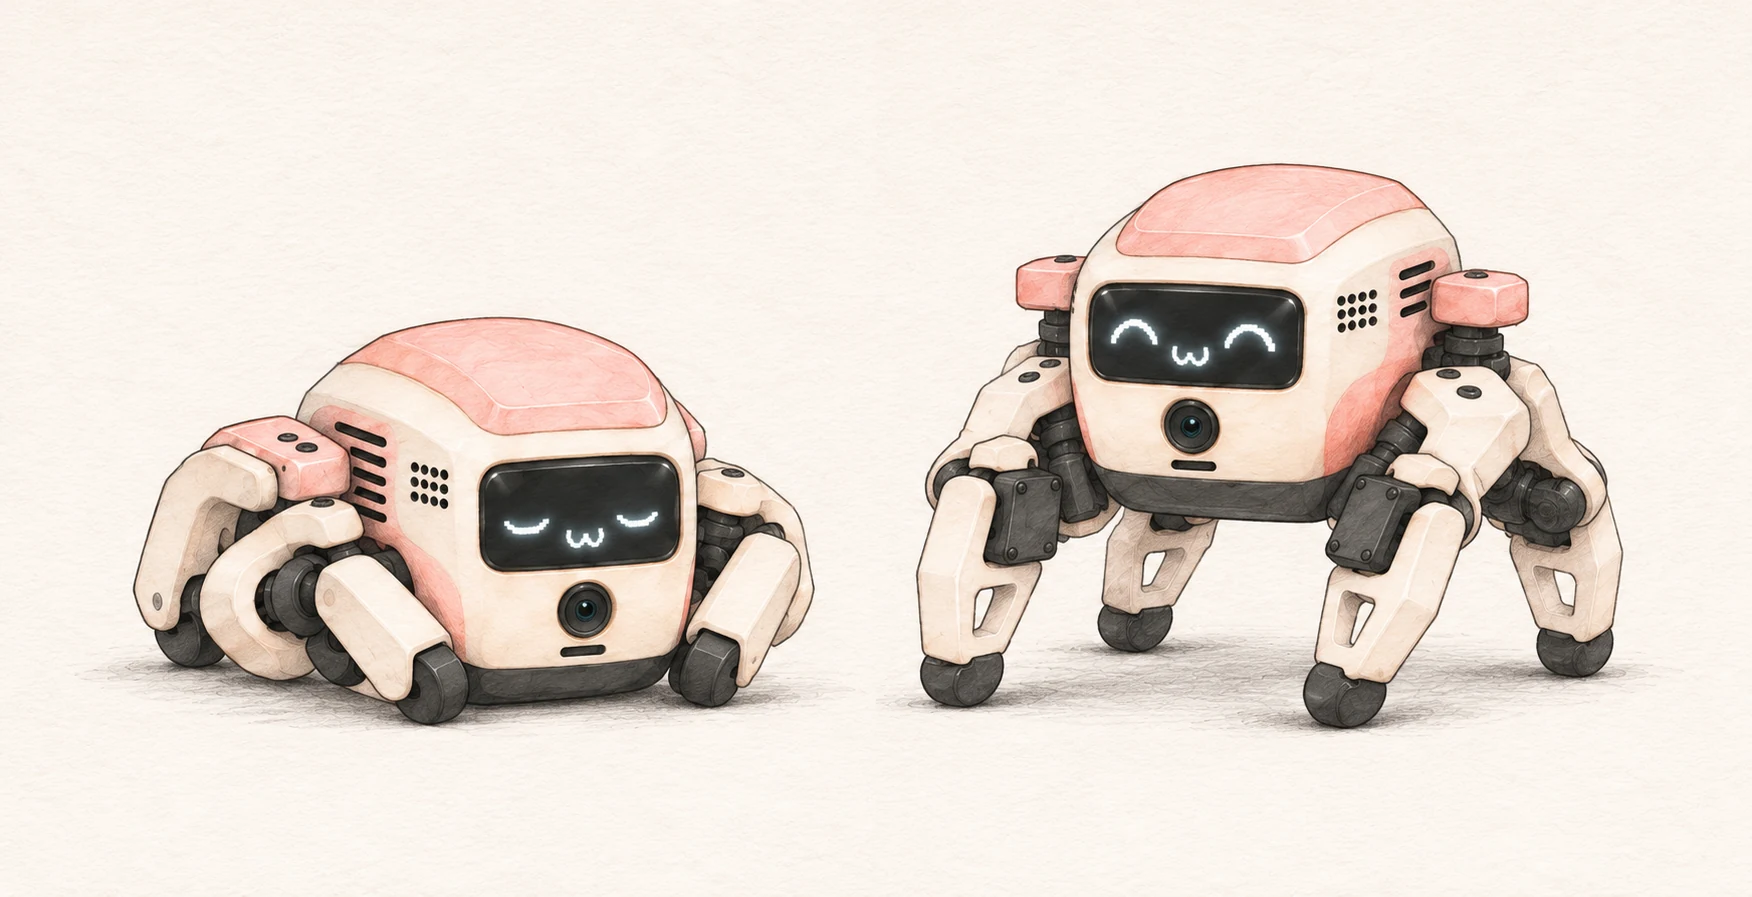
TurnBench, SLURP ו InstructTTSEval תוצאות עבור זמני ריצה מקומיים ו- API בענן, עם p99 VAP מודל הורדות.
משקל פתוח GLiNER2.5-Decide ב MLX Swift נגד TypeSafe's אירח Jev: מה כל אחד מציע, מה האינדקס שפורסם בהשוואה, ומדידות מקומיות: 7.6 מ"מ לבקשה ב 0.85 GB עם INT8

סרט קונספט בוחן את החזון של Stenograf על מנת להפוך את השיחות לצעדים הבאים שימושיים.
מ Moshi ו PersonaPlex VoiceChat: כיצד דיבור מלא-דופלקס מטפל בהפרעות ו MCP כלים, והיכן קטן Android
כלים להקלטות ולמוזיקה שלכם.
יישום חינמי
צרו פלייבקים לקריוקי מהאודיו שלכם. הסירו שירה, הפרידו ערוצי כלים, שנו סולם וייצאו קובצי WAV בחינם ב-Android, ב-iPhone וב-iPad.
גלו את היישוםCLI של Homebrew
תמלול, סינתזת דיבור וכלי אודיו שפועלים מקומית במחשבי Mac עם Apple Silicon.
brew install speechמדריך התקנההקלטה חופשית ותעתיק
הקלטות ותמלולים פרטיים ב-Mac, ב-Windows וב-Android. AI אופציונלי במחשב מוסיף סיכומים וצ'אט.
גלו את היישוםשירותים
אנחנו מאמנים ומתאימים מודלים, מעריכים אותם על הנתונים שלכם ומשלבים אותם במכשירים או בתשתית הפרטית שלכם.
גלו את השירותיםפתחו זיהוי דיבור, קולות הבעתיים ושליטה קולית שמותאמים לאופן שבו המשתמשים שלכם מדברים.
בנה את צינורות השמע סביב סביבת ההאזנה וחומרת היעד.
הפעל את המודלים שלך על המכשיר או בתוך התשתית שלך.
עזרו למשתמשים שלכם למצוא מקורות רלוונטיים ולבנות זרימות מחקר שהם יכולים לבדוק.
גלו את הארכיטקטורה, ה-CLI, ממשקי ה-SDK ומבחני הביצועים של כל רכיב.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
עיצוב קול ניסיוני - חבילות ציבוריות - לבנות SDK
עיצוב קול ניסיוני - חבילות ציבוריות - לבנות SDK
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
5.3M, Float32
תחזית דיבור של שני ערוצים, 5.8 מיליון, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8