Oppdatert oktober 31, 2026 · Soniqos blogg
Måling av taleagenter: samtaleturer, verktøykall og uttrykksfull tale
TurnBench, SLURP og InstructTTSEval-resultater for lokale løpstider og sky-APIer, med nye p99 samt VAP -modeller.
Les
Utskrift og montering pågår
Vi bygger en liten robot du kan snakke med. Fire bein, et lite digitalt ansikt og lokal AI på en bærbar datamaskin eller telefon i nærheten kobler ordene dine til robotens neste bevegelse.
Møt Mimi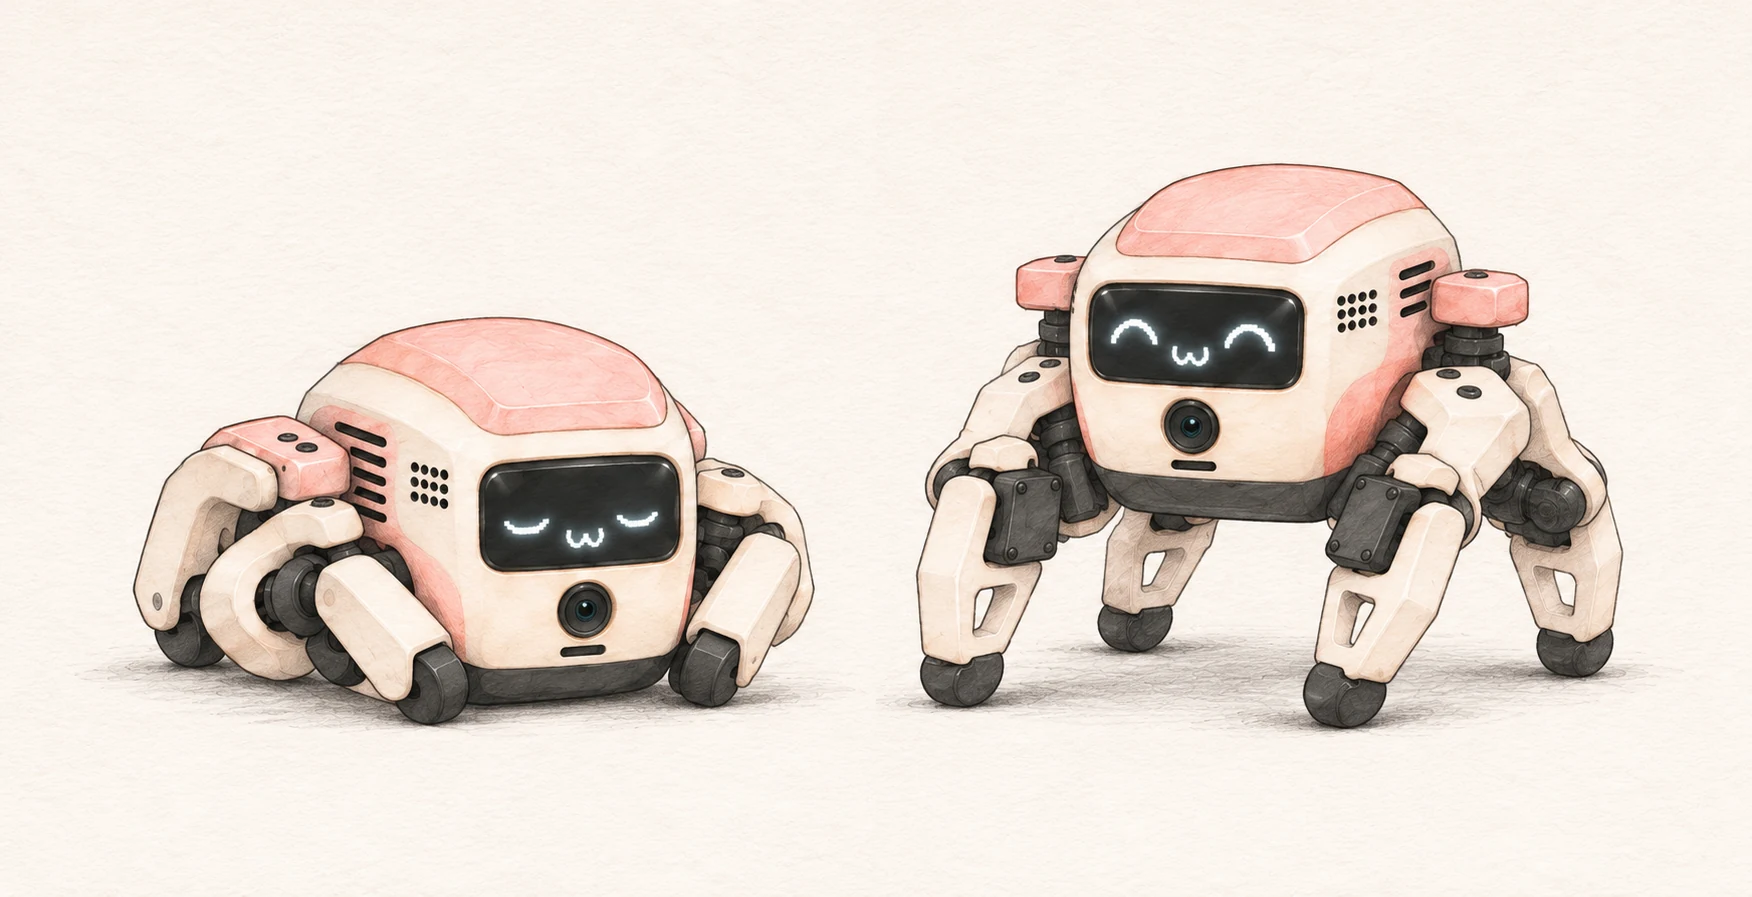
TurnBench, SLURP og InstructTTSEval-resultater for lokale løpstider og sky-APIer, med nye p99 samt VAP -modeller.
Åpen vekt GLiNER2.5-Decide i MLX Swift mot TypeSafes vert Jev: hva hvert tilbud, hva det publiserte referansetallet sammenlignet, og lokale målinger: 7,6 ms per forespørsel på 0.85 GB med INT8.

En konseptfilm som utforsker Stenografs visjon for å gjøre samtaler til nyttige neste skritt.
Fra Moshi og PersonaPlex til VoiceChat: hvor full-duplex tale håndterer avbrudd og MCP verktøy, og hvor en mindre Android kommandorørledning passer.
Verktøy for opptakene og musikken din.
Gratis app
Lag karaokebakgrunner fra din egen lyd. Fjern vokal, skill ut instrumenter, endre toneart og eksporter WAV-filer gratis på Android, iPhone og iPad.
Utforsk appenHomebrew CLI
Transkripsjon, talesyntese og lydverktøy som kjører lokalt på Mac med Apple Silicon.
brew install speechInstallasjonsveiledningGratis opptak og transkripsjon
Private opptak og transkripsjoner på Mac, Windows og Android. Valgfri AI på datamaskinen gir sammendrag og chat.
Utforsk appenTjenester
Vi trener og tilpasser modeller, evaluerer dem med dataene dine og integrerer dem i enhetene dine eller din private infrastruktur.
Utforsk tjenesteneBygg talegjenkjenning, uttrykksfulle stemmer og stemmestyring rundt måten brukerne dine snakker på.
Bygg lydrørledningen din rundt lyttemiljøet og målmaskinvaren.
Kjør dine modeller på enheten eller innenfor din egen infrastruktur.
Hjelp brukerne til å finne relevante kilder og bygge forskningsarbeidsflyter de kan sjekke.
Utforsk arkitektur, CLI, SDK-API-er og ytelsestester for hver komponent.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Eksperimentell stemmedesign · offentlige pakker · bygg SDK hoved
Eksperimentell stemmedesign · offentlige pakker · bygg SDK hoved
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Streaming sluttresultater, 5.3M, Float32
Tokanals taleprognoser, 5.8M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8