Măsurarea agenților vocali: alternarea replicilor, apeluri de instrumente și vorbire expresivă
TurnBench, SLURP și InstructTTSEval rezultate pentru runtime-uri locale și API-uri cloud, cu noi p99 si VAP descărcări model.
Imprimare și asamblare în curs
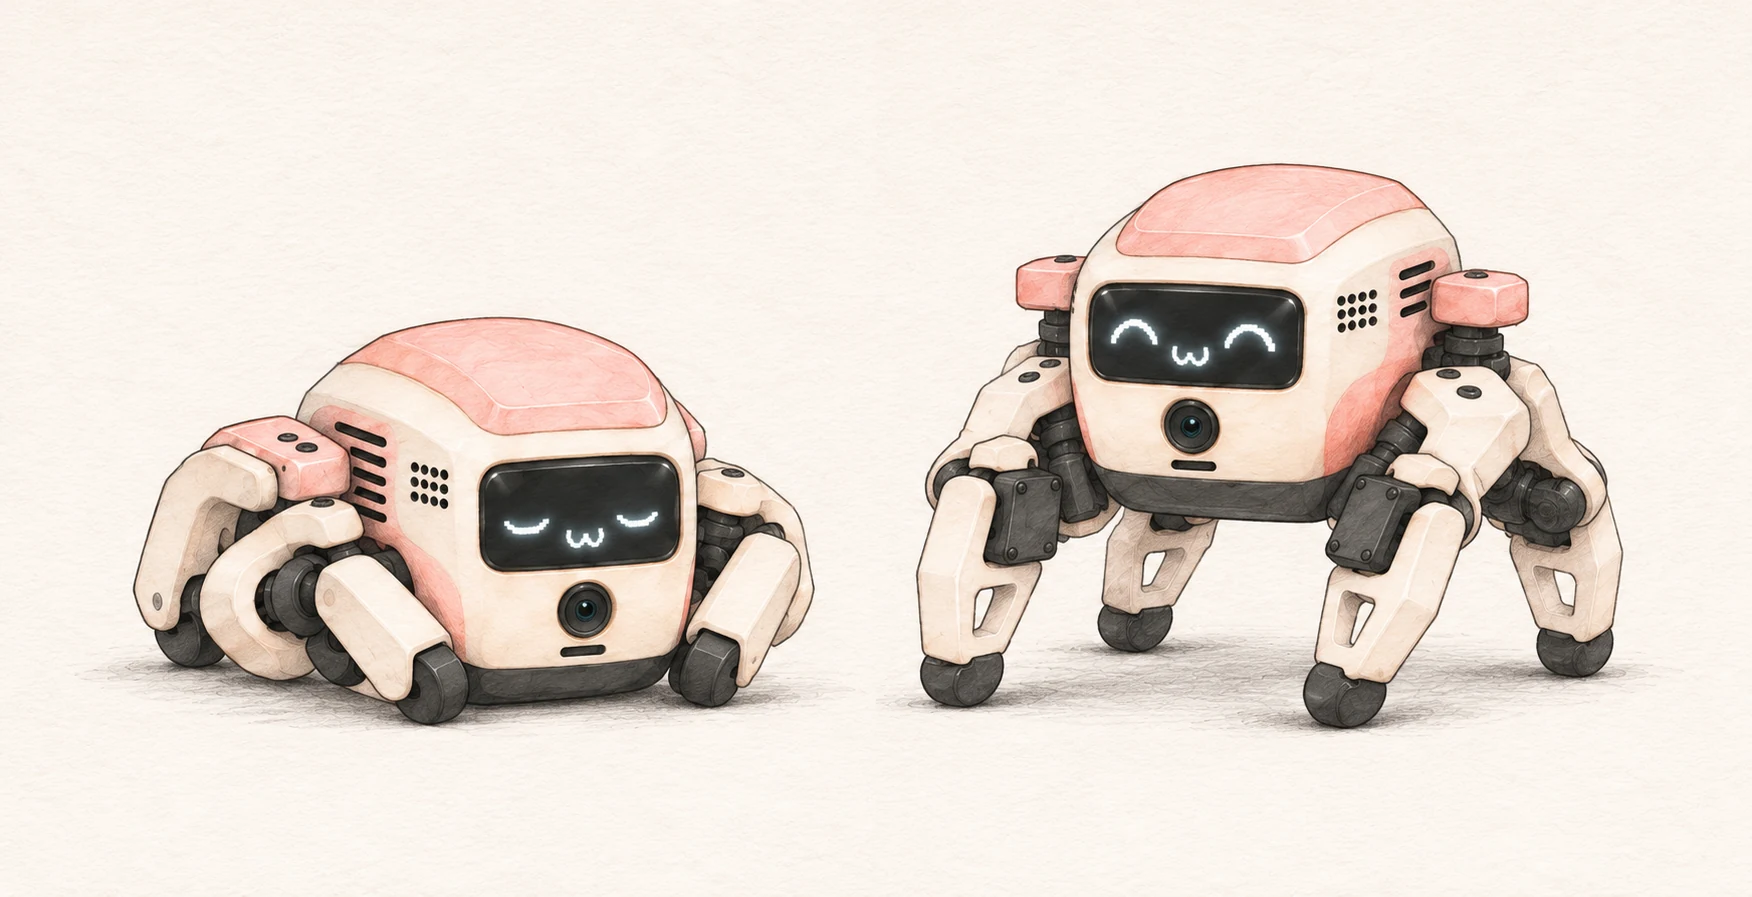
Construim un mic robot cu care să poți vorbi. Patru picioare, o mică față digitală și AI local pe un laptop sau telefon din apropiere vor lega cuvintele tale de următoarea sa mișcare.
Fă cunoștință cu Mimi
TurnBench, SLURP și InstructTTSEval rezultate pentru runtime-uri locale și API-uri cloud, cu noi p99 si VAP descărcări model.
Open-weight GLiNER2.5-Decide în MLX Swift împotriva TypeSafe: ceea ce fiecare oferă, ceea ce a publicat de referință în comparație, și măsurători locale: 7.6 ms la cerere la 0.85 GB cu INT8.

Un concept de film explorând Stenograf
De la Moshi și PersonaPlex până la VoiceChat: modul în care se ocupă complet de întreruperile vorbirii și instrumentele MCP și unde o conductă de comandă mai mică Android se potrivește.
Instrumente pentru înregistrările și muzica ta.
Aplicație gratuită
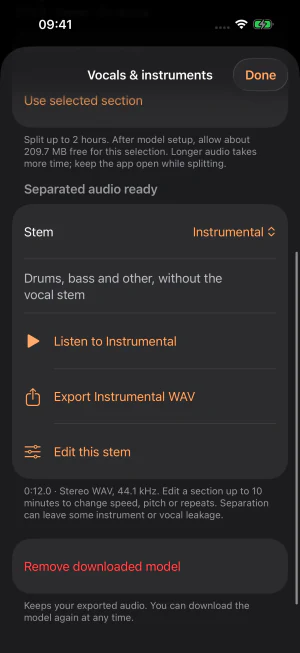
Creează acompaniamente karaoke din propriile fișiere audio. Elimină vocea, separă instrumentele, schimbă tonalitatea și exportă WAV gratuit pe Android, iPhone și iPad.
Descoperă aplicațiaCLI Homebrew
Transcriere, sinteză vocală și instrumente audio care rulează local pe Mac cu Apple Silicon.
brew install speechGhid de instalareÎnregistrarea și transcrierea gratuite
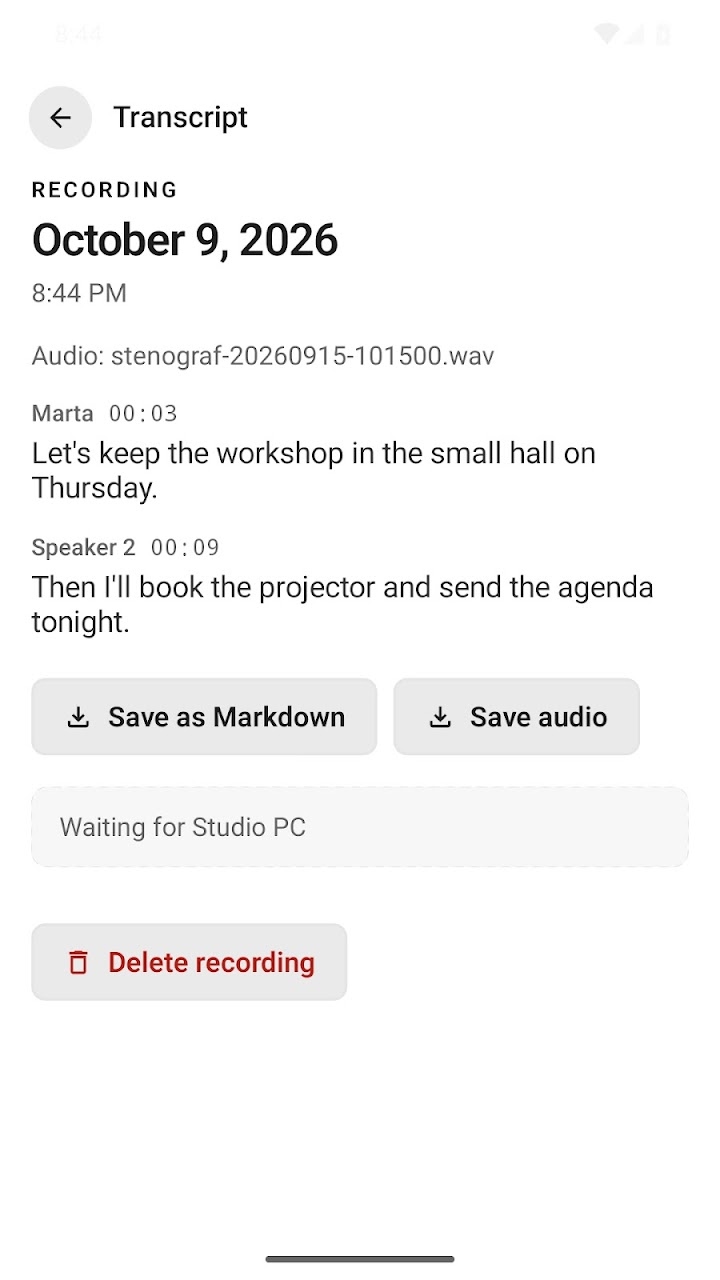
Înregistrări și transcrieri private pe Mac, Windows și Android. AI opțional pe desktop adaugă rezumate și chat.
Descoperă aplicațiaServicii
Antrenăm și adaptăm modele, le evaluăm pe datele tale și le integrăm în dispozitivele sau infrastructura ta privată.
Descoperă serviciileConstruiește recunoaștere vocală, voci expresive și comenzi vocale adaptate felului în care vorbesc utilizatorii tăi.
Construiți conducta audio în jurul mediului de ascultare și hardware-ul țintă.
Rulați modelele pe dispozitiv sau în cadrul propriei infrastructuri.
Ajutați utilizatorii să găsească surse relevante și să construiască fluxuri de lucru de cercetare pe care le pot verifica.
Explorează arhitectura, CLI, API-urile SDK și testele de performanță ale fiecărei componente.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Proiectare vocală experimentală · pachete publice · construcţie SDK principal
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Scoruri de întoarcere prin streaming, 5.3M, Float32
Previziuni de vorbire cu două canale, 5,8M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8