Opdateret oktober 31, 2026 · Soniqo 's Blog
Måling af taleagenter: samtaleture, værktøjskald og udtryksfuld tale
TurnBench, SLURP og InstructTTSEval resultater for lokale runtimes og cloud API 'er, med nye p99 og VAP model downloads.
Læs
Udskrivning og samling er i gang
Vi bygger en lille robot, du kan tale med. Fire ben, et lille digitalt ansigt og lokal AI på en bærbar computer eller telefon i nærheden forbinder dine ord med robottens næste bevægelse.
Mød Mimi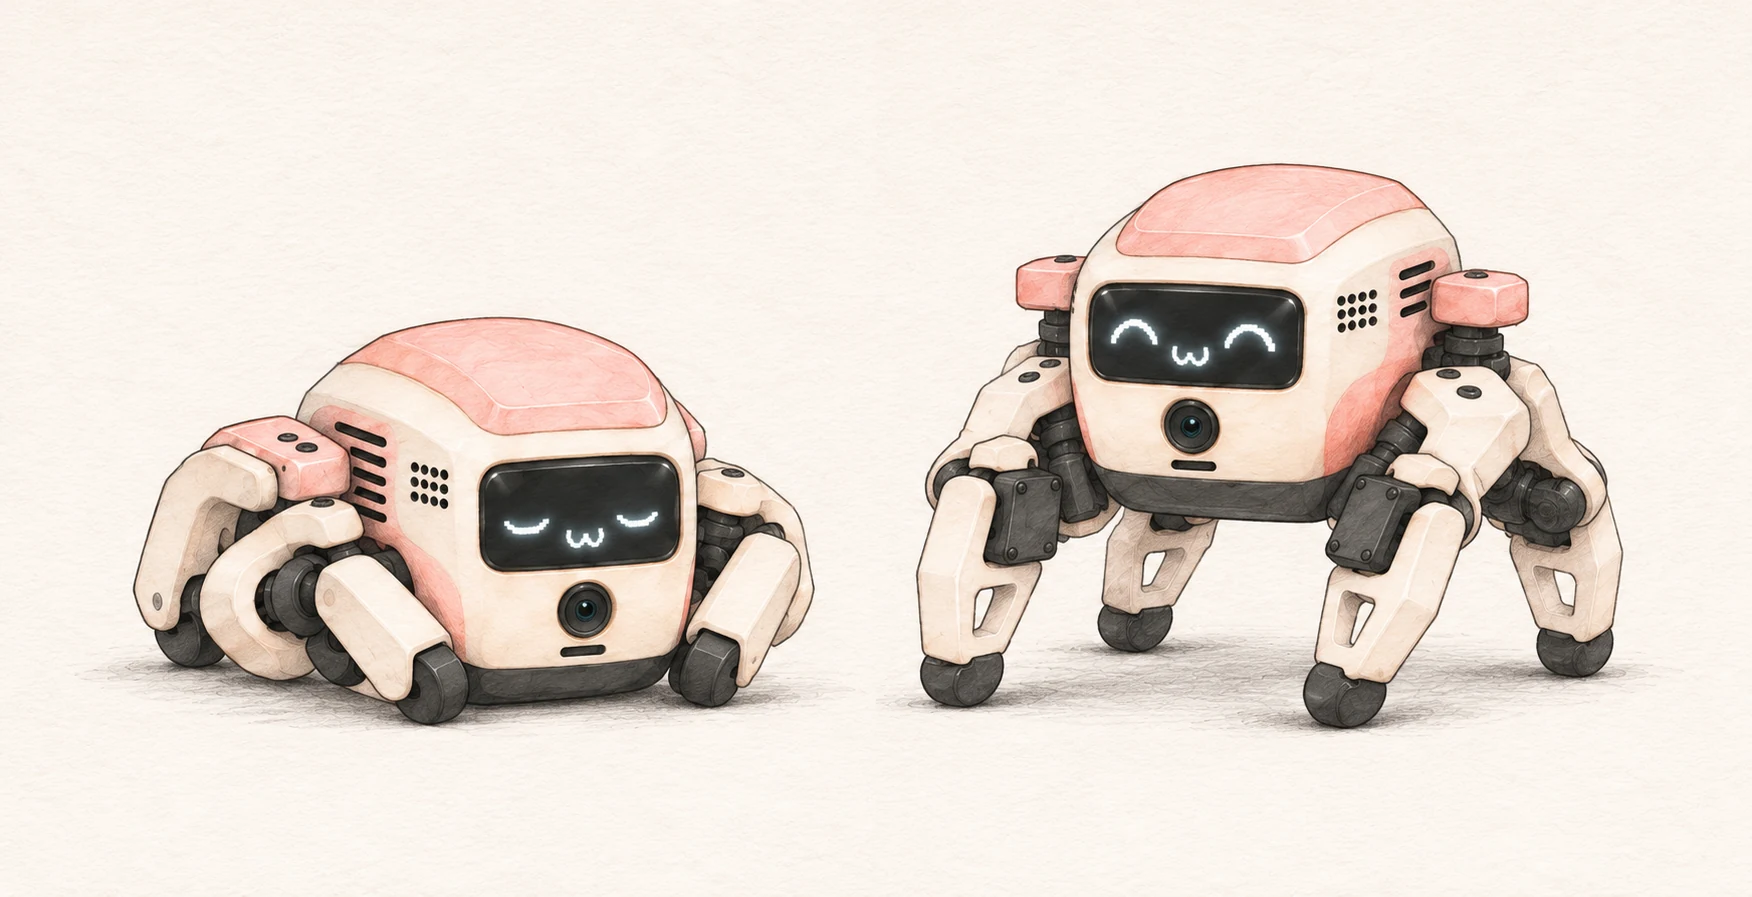
TurnBench, SLURP og InstructTTSEval resultater for lokale runtimes og cloud API 'er, med nye p99 og VAP model downloads.
Open- weight GLiNER2.5-Decide i MLX Swift mod TypeSafe 's hosted Jev: hvad hver tilbyder, hvad den offentliggjorte benchmark sammenlignet, og lokale målinger: 7.6 ms per anmodning på 0.85 GB med INT8.

En konceptfilm, der udforsker Stenograf 's vision for at gøre samtaler til nyttige næste skridt.
Fra Moshi og PersonaPlex til VoiceChat: hvordan full-duplex tale håndterer afbrydelser og MCP værktøjer, og hvor en mindre Android Kommandorørledning passer.
Værktøjer til dine optagelser og din musik.
Gratis app
Lav karaokebaggrunde af din egen lyd. Fjern vokal, adskil instrumenter, skift toneart og eksportér WAV-filer gratis på Android, iPhone og iPad.
Udforsk appenHomebrew CLI
Transskription, talesyntese og lydværktøjer, der kører lokalt på Mac med Apple Silicon.
brew install speechInstallationsvejledningGratis optagelse og transskription
Private optagelser og transskriptioner på Mac, Windows og Android. Valgfri AI på computeren tilføjer resuméer og chat.
Udforsk appenYdelser
Vi træner og tilpasser modeller, evaluerer dem med dine data og integrerer dem i dine enheder eller din private infrastruktur.
Udforsk ydelserneByg talegenkendelse, udtryksfulde stemmer og stemmestyring ud fra den måde, dine brugere taler på.
Byg din lydledning rundt om lyttemiljøet og mål hardware.
Kør dine modeller på enheden eller inden for din egen infrastruktur.
Hjælp dine brugere med at finde relevante kilder og opbygge forskningsarbejdsgange, som de kan kontrollere.
Udforsk arkitektur, CLI, SDK-API’er og ydelsestest for hver komponent.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Eksperimentelt talemønster · offentlige bundter · build SDK main
Eksperimentelt talemønster · offentlige bundter · build SDK main
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Streaming end-of-turn scores, 5.3M Float32
Prognoser for two-channel tale 5.8M Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8