Mengukur agen suara: pergantian giliran bicara, pemanggilan alat, dan ucapan ekspresif
TurnBench, SLURP dan InstructTTSEval hasil untuk runtimes lokal dan awan APIs, dengan baru p99 dan VAP Model download.
Pencetakan dan perakitan berlangsung
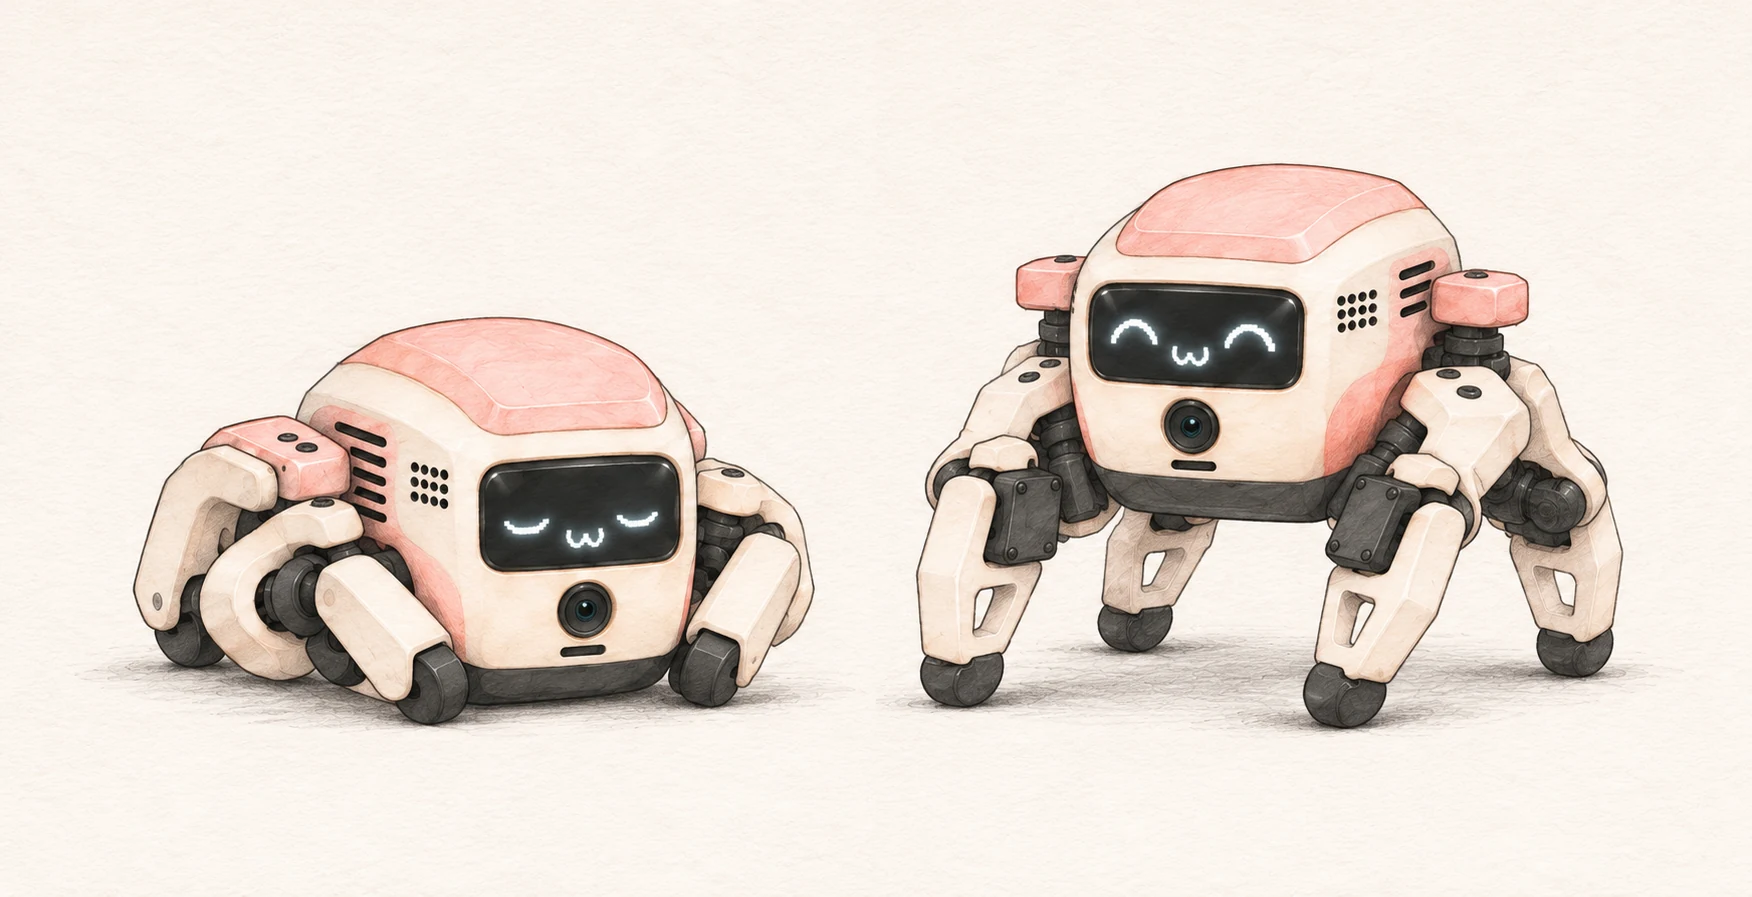
Kami sedang membuat robot kecil yang bisa Anda ajak bicara. Empat kaki, wajah digital kecil, dan AI lokal di laptop atau ponsel terdekat menghubungkan kata-kata Anda dengan gerakan berikutnya.
Kenali Mimi
TurnBench, SLURP dan InstructTTSEval hasil untuk runtimes lokal dan awan APIs, dengan baru p99 dan VAP Model download.
Open-weight GLiNER2.5-Decide in MLX Swift Terhadap TypeSafe, Jev: apa yang ditawarkan setiap orang, apa yang diterbitkan benchmark dibandingkan, dan pengukuran lokal: 7.6 ms per permintaan di 0.85 GB dengan INT8.

Sebuah film konsep menjelajahi visi Stenograf untuk mengubah percakapan menjadi langkah-langkah berikutnya yang berguna.
Dari Moshi dan PersonaPlex ke VoiceChat: bagaimana penugasan penuh pidato menangani interupsi dan alat-alat MCP, dan dimana Android yang lebih kecil cocok dengan jalur pipa.
Alat untuk rekaman dan musik Anda.
Aplikasi gratis
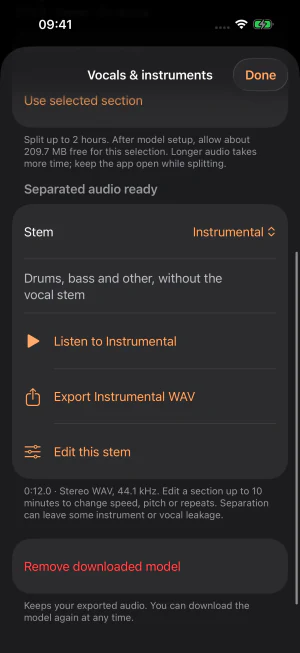
Buat musik pengiring karaoke dari audio Anda sendiri. Hapus vokal, pisahkan instrumen, ubah nada dasar, dan ekspor WAV gratis di Android, iPhone, dan iPad.
Jelajahi aplikasiCLI Homebrew
Transkripsi, sintesis ucapan, dan alat audio yang berjalan di perangkat untuk Mac dengan Apple Silicon.
brew install speechPanduan instalasiRekam dan transkripsi bebas
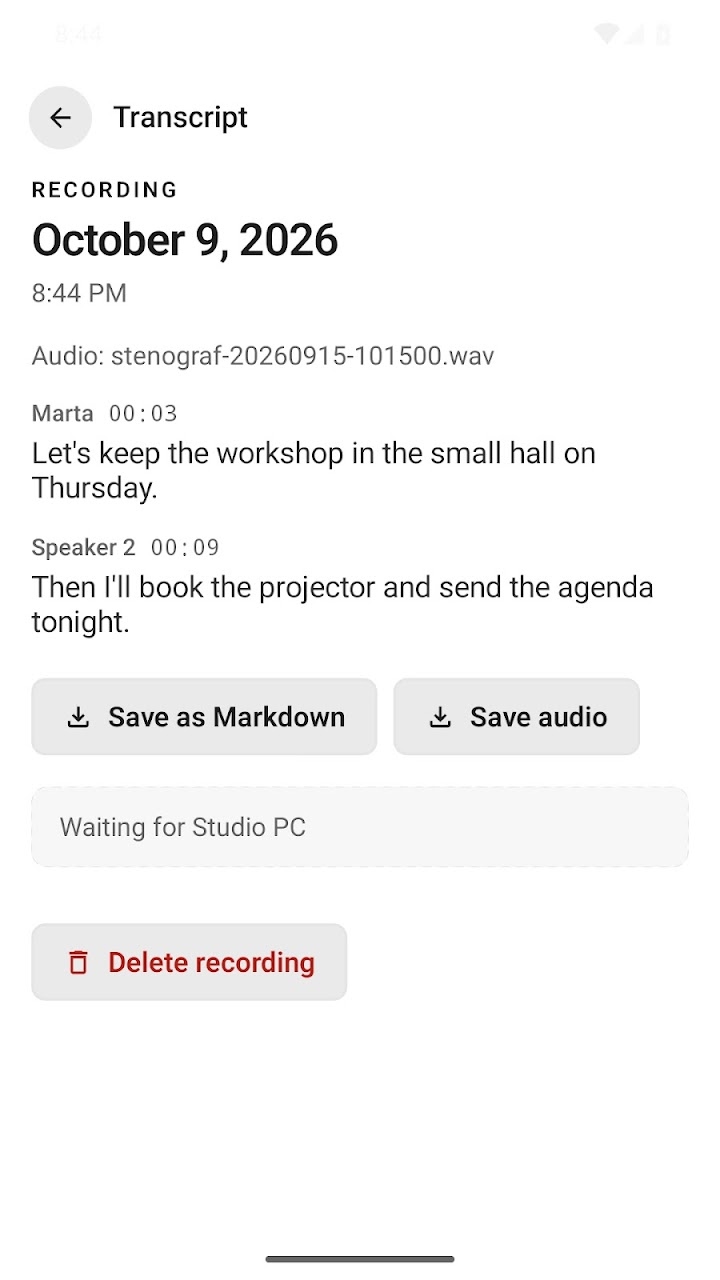
Perekaman dan transkripsi privat di Mac, Windows, dan Android. AI desktop opsional menambahkan ringkasan dan percakapan.
Jelajahi aplikasiLayanan
Kami melatih dan menyesuaikan model, mengevaluasinya dengan data Anda, lalu mengintegrasikannya ke perangkat atau infrastruktur privat Anda.
Jelajahi layananBangun pengenalan ucapan, suara ekspresif, dan kontrol suara sesuai cara pengguna Anda berbicara.
Bangun pipeline audio Anda di sekitar lingkungan mendengarkan dan target perangkat keras.
Jalankan model Anda pada perangkat atau dalam infrastruktur Anda sendiri.
Membantu pengguna Anda menemukan sumber yang relevan dan membangun aliran penelitian yang dapat mereka periksa.
Jelajahi arsitektur, CLI, API SDK, dan tolok ukur setiap komponen.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Desain suara percobaan SDK utama
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Streaming end-of-turn score, 5.3M, Float32
Dua- saluran prakiraan pidato, 5.8M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8