Uppdaterad oktober 31, 2026 · Soniqos blogg
Mätning av röstagenter: samtalsturer, verktygsanrop och uttrycksfullt tal
TurnBench, SLURP och InstructTTSEval resultat för lokala runtimes och moln API, med nya p99 och VAP modell nedladdningar.
Läs mer
Utskrift och montering pågår
Vi bygger en liten robot som du kan prata med. Fyra ben, ett litet digitalt ansikte och lokal AI på en dator eller telefon i närheten kopplar dina ord till robotens nästa rörelse.
Möt Mimi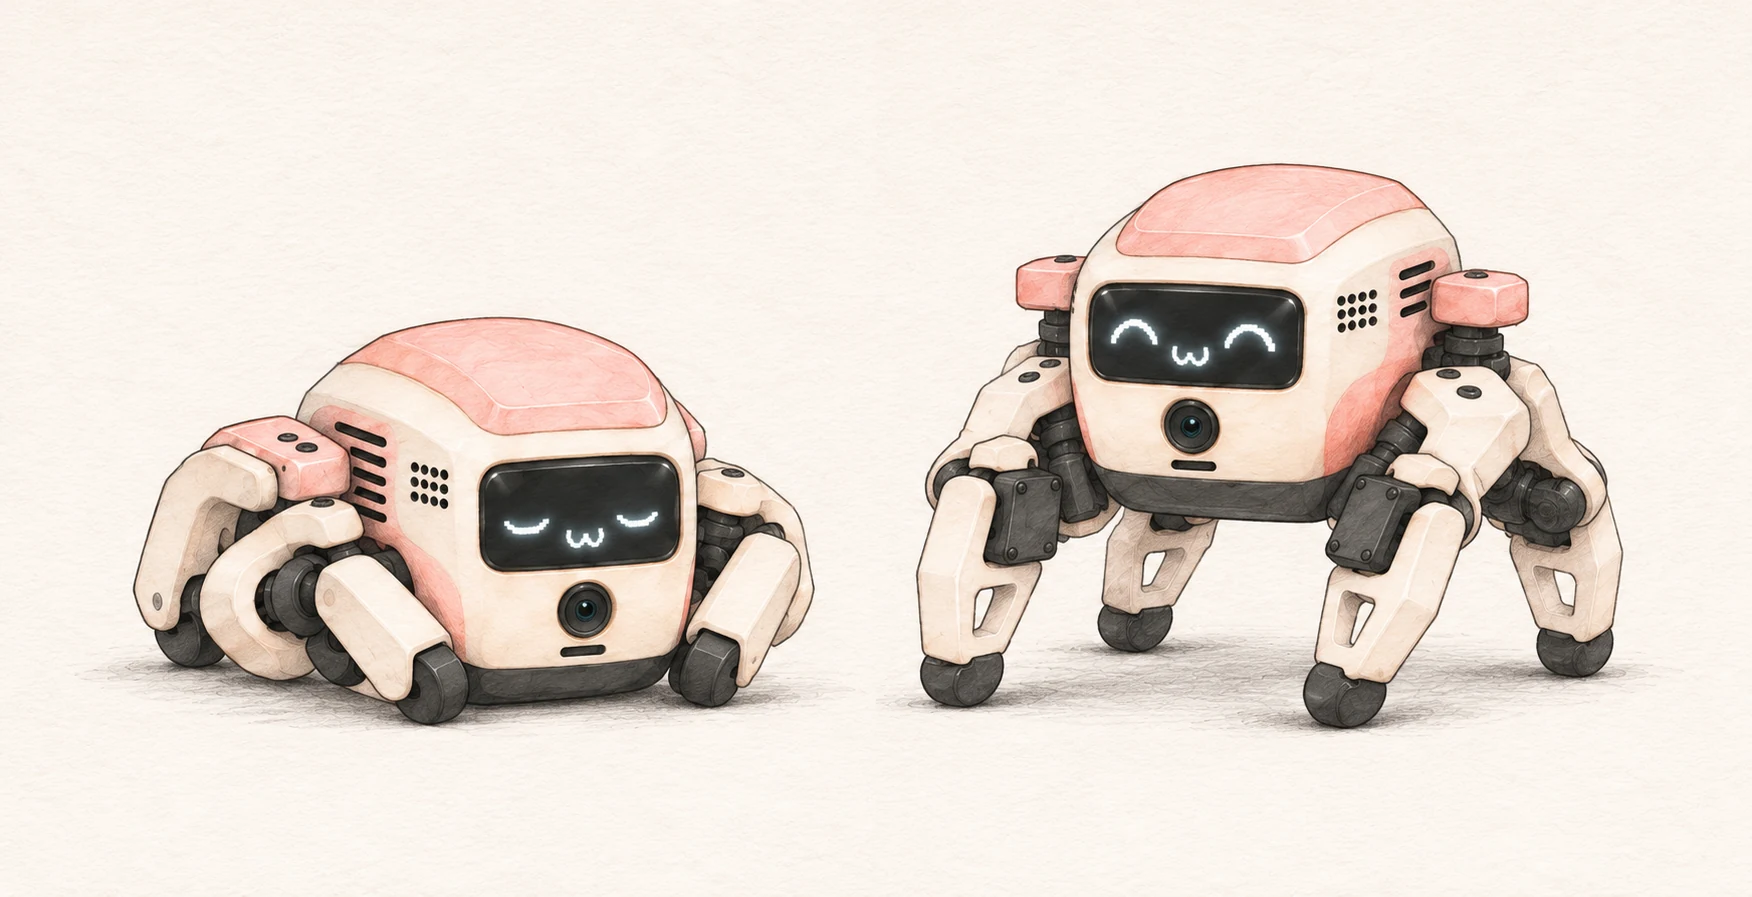
TurnBench, SLURP och InstructTTSEval resultat för lokala runtimes och moln API, med nya p99 och VAP modell nedladdningar.
Open-weight GLiNER2.5-Decide i MLX Swift mot TypeSafes värd Jev: vad varje erbjudanden, vad det publicerade referensvärdet jämförde och lokala mätningar: 7.6 ms per förfrågan på 0.85GB med INT8.

En konceptfilm som utforskar Stenograf vision för att omvandla konversationer till användbara nästa steg.
Från Moshi och PersonaPlex till VoiceChat: hur full-duplex tal hanterar avbrott och MCP verktyg, och där en mindre Android kommandotpipeline passar.
Verktyg för dina inspelningar och din musik.
Gratis app
Skapa karaokebakgrunder från ditt eget ljud. Ta bort sång, separera instrument, ändra tonart och exportera WAV-filer gratis på Android, iPhone och iPad.
Utforska appenHomebrew CLI
Transkription, talsyntes och ljudverktyg som körs lokalt på Mac med Apple Silicon.
brew install speechInstallationsguideGratis inspelning och transkription
Privata inspelningar och transkriptioner på Mac, Windows och Android. Valfri AI på datorn ger sammanfattningar och chatt.
Utforska appenTjänster
Vi tränar och anpassar modeller, utvärderar dem med dina data och integrerar dem i dina enheter eller din privata infrastruktur.
Utforska tjänsternaBygg taligenkänning, uttrycksfulla röster och röststyrning utifrån hur dina användare talar.
Bygg din ljudpipeline runt lyssnarmiljön och rikta hårdvara.
Kör dina modeller på enheten eller inom din egen infrastruktur.
Hjälp dina användare att hitta relevanta källor och bygga forskningsflöden som de kan kontrollera.
Utforska arkitektur, CLI, SDK-API:er och prestandatester för varje komponent.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Experimentell röstdesign · offentliga buntar · bygga SDK huvud
Experimentell röstdesign · offentliga buntar · bygga SDK huvud
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Streaming end-of-turn poäng, 5.3M, Float32
Tvåkanalsprognoser, 5,8 M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8