Bijgewerkt op 31 oktober 2026 · Soniqo
Spraakassistenten meten: gespreksbeurten, toolaanroepen en expressieve spraak
TurnBench, SLURP en InstructTTSEval resultaten voor lokale runtimes en cloud API's, met nieuwe p99 en VAP modeldownloads.
Gelezen
Printen en assembleren in uitvoering
We bouwen een kleine robot waarmee je kunt praten. Vier poten, een klein digitaal gezicht en lokale AI op een laptop of telefoon in de buurt verbinden je woorden met zijn volgende beweging.
Maak kennis met Mimi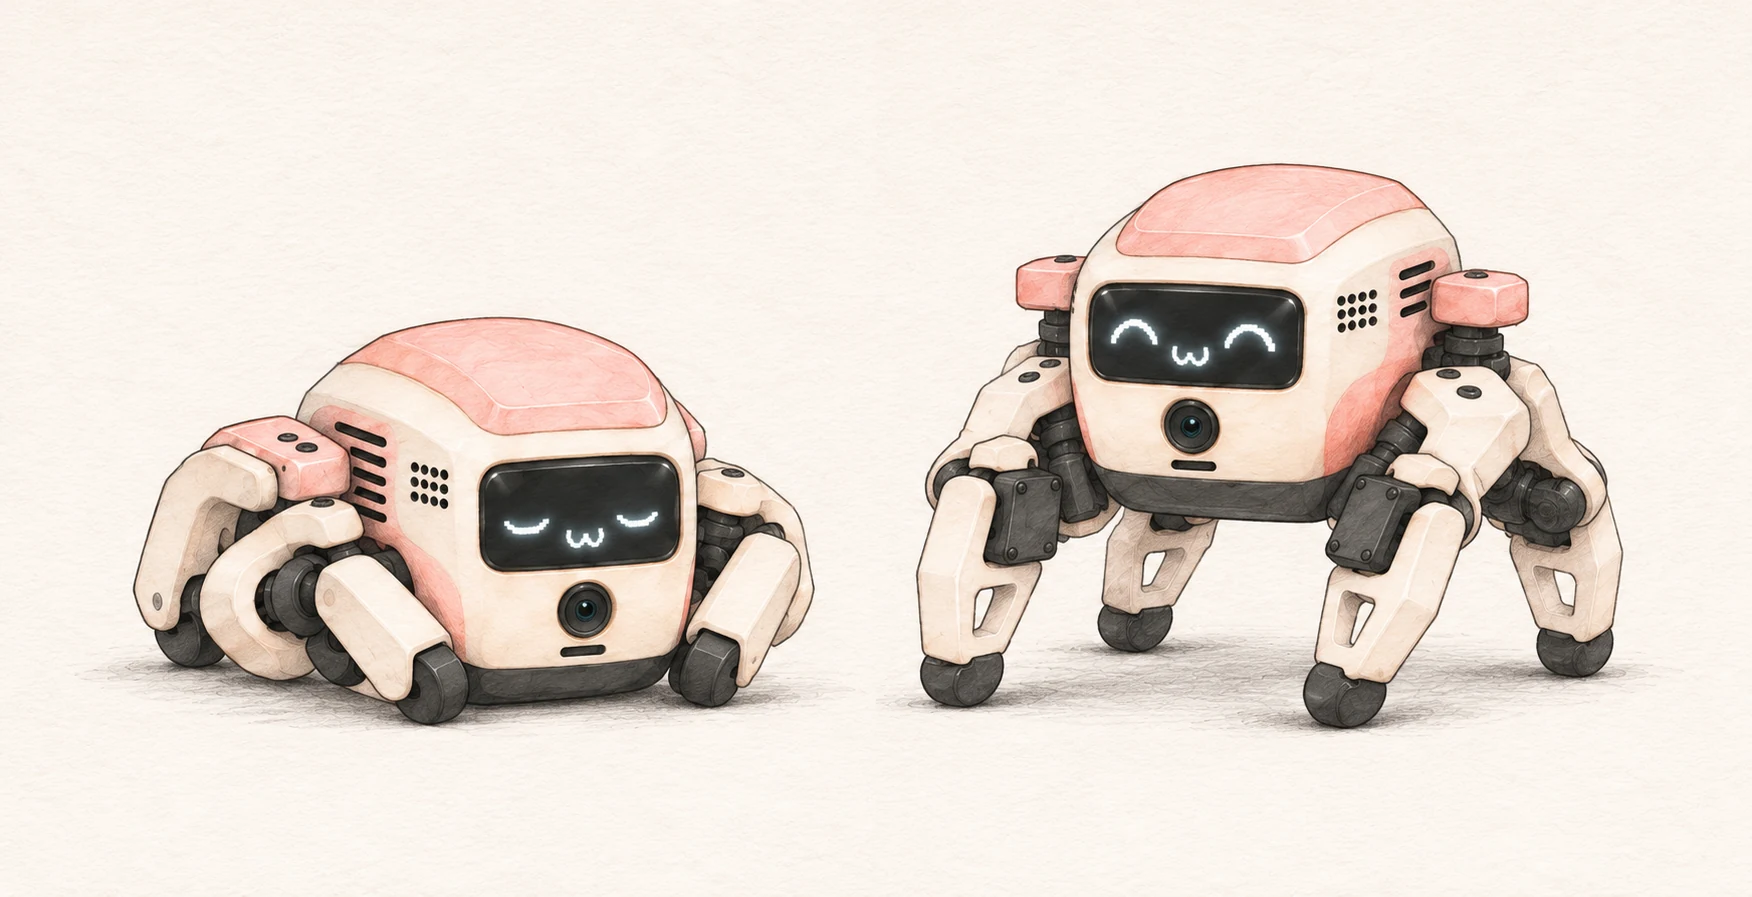
TurnBench, SLURP en InstructTTSEval resultaten voor lokale runtimes en cloud API's, met nieuwe p99 en VAP modeldownloads.
Open-gewicht GLiNER2.5-Decide in MLX Swift tegen TypeSafeUs gehost Jev: wat elk biedt, wat de gepubliceerde benchmark vergeleken, en lokale metingen: 7.6 ms per verzoek bij 0.85 GB met INT8.

Een conceptfilm die Stenograf verkent, maakt van conversaties een nuttige volgende stap.
Van Moshi en PersonaPlex naar VoiceChat: hoe full-duplex spraak interrupts en MCP tools behandelt, en waar een kleinere Android commandopijplijn past.
Tools voor je opnamen en muziek.
Gratis app
Maak karaoke-begeleiding van je eigen audio. Verwijder zang, splits instrumenten, wijzig de toonsoort en exporteer gratis WAV-bestanden op Android, iPhone en iPad.
Ontdek de appHomebrew CLI
Transcriptie, spraaksynthese en audiotools die lokaal draaien op Macs met Apple Silicon.
brew install speechInstallatiehandleidingGratis opname en transcriptie
Privéopnamen en transcripties op Mac, Windows en Android. Optionele desktop-AI voegt samenvattingen en chat toe.
Ontdek de appDiensten
We trainen en passen modellen aan, evalueren ze met je gegevens en integreren ze in je apparaten of eigen infrastructuur.
Bekijk onze dienstenOntwikkel spraakherkenning, expressieve stemmen en spraakbediening die aansluiten op hoe je gebruikers spreken.
Bouw uw audiopijplijn rond de luisteromgeving en doelhardware.
Start uw modellen op het apparaat of binnen uw eigen infrastructuur.
Help uw gebruikers relevante bronnen te vinden en onderzoeksworkflows op te bouwen die ze kunnen controleren.
Bekijk de architectuur, CLI, SDK-API’s en benchmarks van elk onderdeel.
52 langs, RTF 0.06, 4-/8-bit
Native CoreML: 1.40% WER, 6 s model load
MLX INT5: 128K offline context, RTF 0.028
Small, medium, large-v3, and turbo exports
32× real-time on Neural Engine
120M, 25 langs, streaming partials + EOU, ~232 MB on-device
1,672 languages, 300M–7B
14 langs, INT5 default, RTF 0.015
8 langs, INT5 default, RTF 0.074
Word-level timestamps, 80 ms
Streaming with punctuation
EN/ZH, voice design + cloning, 24 kHz, non-commercial
48 kHz stereo, 80 ms streaming, reference voice cloning
20 presets, 9 langs, 24 kHz, 4-bit, CC BY-NC 4.0
9 langs, zero-shot cloning, bf16 / 8-bit
12 Hz codec LM, faster than real-time
Experimenteel spraakontwerp · openbare bundels · bouwen SDK hoofd
Experimenteel spraakontwerp · openbare bundels · bouwen SDK hoofd
48 kHz, 30 langs, voice design + cloning
Zero-shot cloning, emotion + tempo controls, RTF 1.0
99M, 31 langs, 44.1 kHz
CoreML voice cloning, TTFT 0.27s, RTF 0.59
600+ langs, NAR diffusion cloning
Hindi emotion TTS + raw reference cloning
Style markers + zero-shot cloning
Zero-shot cloning in 16 flow steps, RTF 0.57
4B conversational cloning, emotion tags, RTF 0.78
54 voices, iOS-ready, 10 langs
English, Alba, 24 kHz, 80 ms frames
90-min podcasts / audiobooks
9 langs, 5 baked voices, streaming
IndexTTS2, CosyVoice, Chatterbox Flash, Qwen3-TTS ICL
SpeechBrain ECAPA, 107 languages, 21M
Masked WeSpeaker + native PLDA/VBx, ~32 MB
100M, up to 8 speakers, INT8
Nemotron 3 + Community-1 + Pyannote + Sortformer
WeSpeaker / CAM++ for ID
Silero v6.2.1, Pyannote, FireRedVAD
End-of-turn detection, 23 langs, 3.5 ms per pause
Streaming end-of-turn scores, 5.3M, Float32
Tweekanaals spraakvoorspellingen, 5.8M, Float32
KWS Zipformer, 26× real-time
44.1 kHz stereo, variable-length music
Text → 30 s music, RTF 0.36
Open-Unmix + HTDemucs v4, 4 stems
DeepFilterNet3, 48 kHz real-time
Two-stream echo cancellation, 16 ms latency
Sidon denoise + dereverb → 48 kHz
48 kHz audio super-resolution
MLX Swift · 9B · 4-bit · text decisions · development preview
MLX Swift · INT8, FP16, FP32 · development preview
Streaming on-device LLM
Structured tool / function-call grammar
Many-to-many translation, 400+ languages
Streaming speech translation, FR/ES/PT/DE → EN
Moshi-family full-duplex speech-to-speech
Asymmetric duplex speech-to-speech, INT5 / INT8